Genie 4 与 Genie 3 左右对比
同一间化妆间场景分别由两代模型生成。这是衡量一年变化最直观的一组画面。
来源:Google DeepMind,Genie 4 公告
Genie 4 是 Google DeepMind 于 2026 年 10 月 27 日发布的实时、原生多模态世界模型。
本站是独立解读:它到底能做什么、和 Genie 3 差在哪、以及怎么真正用起来。
独立解读站点 · 与 Google 无关联。所有事实性描述均链接至 DeepMind 官方公告。
Genie 4 是世界模型,不是视频生成器。它不渲染一段固定片段,而是构建一个可用自然语言实时操控的可玩环境——包含物理、环境音,以及会回应你的角色。
Google 未公布 Genie 4 的帧率、输出分辨率、模型规模与定价。你在别处看到的任何具体数字都未经证实。
以下都是 Google DeepMind 随 Genie 4 公告发布的真实演示片段,不是示意图。每张卡片播放的都是原始素材。
同一间化妆间场景分别由两代模型生成。这是衡量一年变化最直观的一组画面。
来源:Google DeepMind,Genie 4 公告
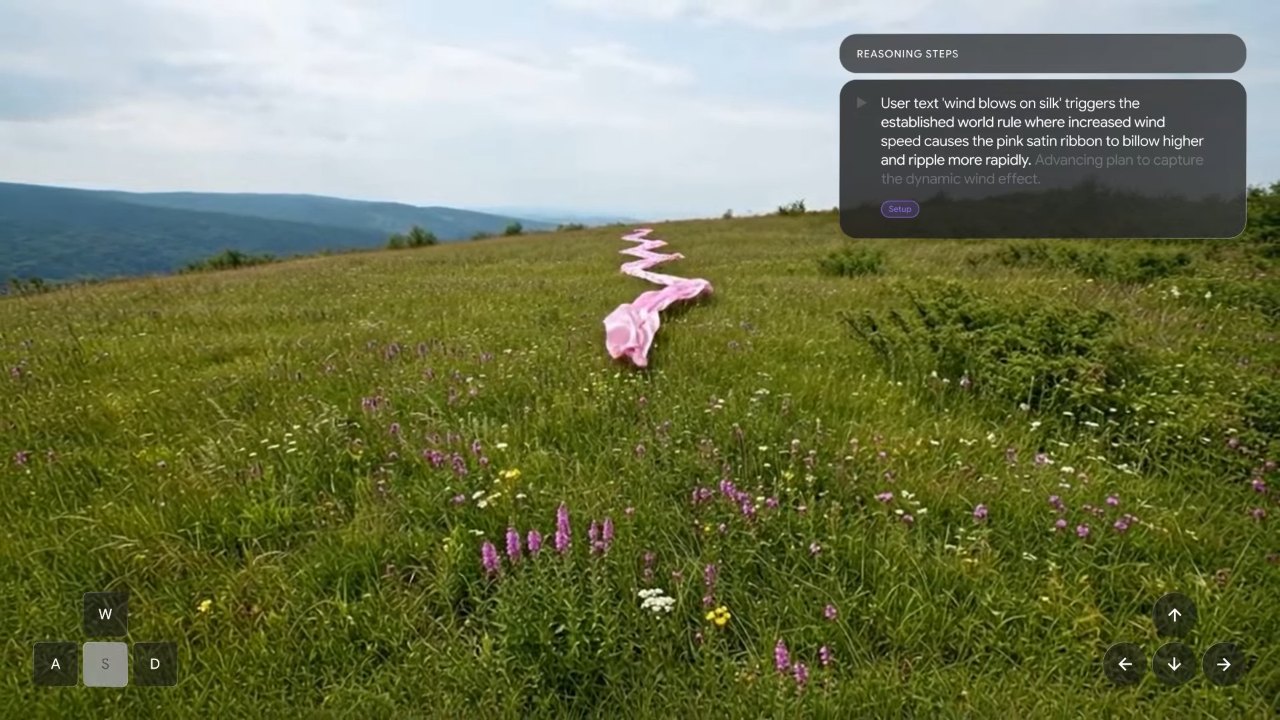
输入「风吹动丝巾」后,粉色缎带在草甸上飘动。右侧推理面板展示了智能体如何解析这条规则。
来源:Google DeepMind,Genie 4 公告
重物落在软物上。直接观察接触物理,以及模拟会把后果推进到什么程度。
来源:Google DeepMind,Genie 4 公告
微距尺度的细节:草叶间的种子,光照与遮挡都处在最容易让生成世界崩坏的尺度上。
来源:Google DeepMind,Genie 4 公告
魔杖、猫与木箱的室内场景。值得看的是视角移动时模型保持了哪些细节。
来源:Google DeepMind,Genie 4 公告
角色在水边演奏。Genie 4 的音频与场景一同生成,这段片子里声音和画面同样重要。
来源:Google DeepMind,Genie 4 公告
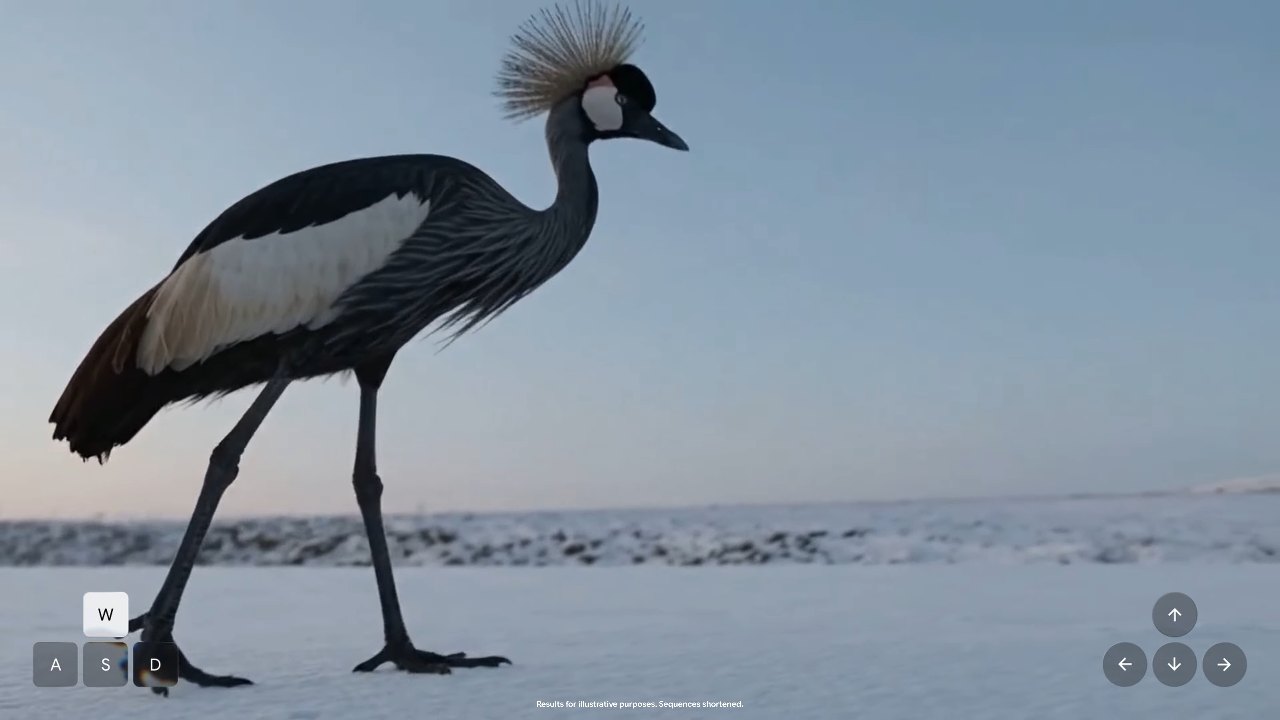
来自开场影片。官方画面自带说明:结果仅供示意、片段经过压缩——判断保真度时值得记住这一点。
来源:Google DeepMind,Genie 4 公告
机械臂在孔板上移动移液枪头,右侧推理面板规划下一步。这就是「智能体训练」用例的具体样子。
来源:Google DeepMind,Genie 4 公告
DeepMind 用在公告文章顶部的那段短循环,可以紧凑地观察世界在帧与帧之间如何维持。
来源:Google DeepMind,Genie 4 公告
片段为 Google DeepMind 发布的原始文件,为保证可访问性由本站重新托管。genie4.art 与 Google 无关联,全部权利归原发布方。部分片段带有 DeepMind 自身的说明:序列已为示意而压缩。
Genie 3 在 2025 年首次实现实时交互,Genie 4 把它从「单个生成场景」推进为「多模态、智能体驱动的模拟」。
| 维度 | Genie 4 | Genie 3 |
|---|---|---|
| 发布时间 | 2026 年 10 月 27 日 | 2025 年 8 月 5 日 |
| 模态 | 原生多模态:画面、环境音、音乐、实时对话 | 视觉帧 + 可提示的世界事件 |
| 推理层 | Gemini Omni 接地,加上 Gemini 3.8 Flash 智能体循环:观察、拆解、校验、重规划 | 官方未描述为智能体驱动 |
| 交互 | 以自然语言实时操控天气、镜头、物体与人物 | 实时导航,加文本触发世界事件 |
| 音频 | 原生环境音 + 可交互角色对话 | 官方未描述原生音频生成 |
| 一致性 | 会话时长更长,但 Google 仍报告长时运行会漂移 | 数分钟内大体一致;视觉记忆约一分钟 |
| 访问 | 受信任测试者、AI Ultra 经 Project Genie、Gemini API 与 AI Studio 合作伙伴 | 面向少量学者与创作者的研究预览 |
Google 未公布的规格——帧率、分辨率、会话时长——此处留空,不做推测。
Scroll the table sideways to see all columns.
DeepMind 把 Genie 4 描述为基于 Gemini 的系统,而不是单一模型。理解这个分层,既能解释它的强项,也能解释它的失败模式。
Gemini Omni 把生成世界锚定在真实外观与行为上,让场景看起来像「地点」而不是一层贴图。
Gemini 3.8 Flash 运行实时循环:观察当前帧、把目标拆成步骤、检查是否达成、在你介入时重新规划。
世界被持续重算,所以你的输入会改变画面,而不是排在固定渲染之后等待。
这是 DeepMind 在公告中重点强调的方向,也是世界模型与文生视频工具的分界线。
改变天气、调整机位、放入新的物体或人物。Gemini 会按上下文重写提示,并在两次编辑之间让场景继续推进。
空气动力学、碰撞、自然的角色动作与反应——这些决定了环境是否有「实体感」。
符合场景的环境音,加上能实时适配的角色对话,与画面一同生成,而不是后期配音。
通过 Gemini 做多步推理来建模因果与程序化行为——这是机器人训练与智能体训练的基础。
每一帧画面与每段音频都带有隐形水印,即使重新编码也能溯源。
在实时会话中注入剧情节拍——暴雨将至、门被推开、人群涌入——无需切镜。
以下是 DeepMind 在公告中列出的工作流,来源是研究预览期间受信任测试者的反馈。
测试者把它描述为场景的「草稿模式」:在实时生成的环境里走位、试一条、反复调整,然后再决定是否投入实景搭建。
在关卡布局、镜头行为或玩法还只是想法时就先感受一遍——不用写引擎代码,也不用先做美术资源。
生成带有因果、多步事件的环境,让具身智能体与机器人在没有硬件、没有实景的情况下反复练习稀有场景。
测试者把二维历史照片变成可漫游的模拟场景——不是看一张静止的图,而是走进那个被记录下来的时刻。
开放是分阶段的。以下是 DeepMind 已确认的信息,以及仍然未知的部分。
大家真正在搜的问题,答案来自官方公告。
更多问题见完整常见问题页。